
Modern uygulamalar sabit koşullarda çalışmıyor. Kullanıcı sayıları hızla değişiyor, trafik beklenmedik anlarda yükseliyor, yeni özelliklerin kısa süre içinde kullanıma sunulması gerekiyor ve birkaç dakikalık hizmet kesintisi bile ciddi sonuçlar doğurabiliyor. Böyle bir ortamda uygulamayı ayakta tutan altyapının da değişime aynı hızla karşılık verebilmesi bekleniyor.
Bu dönüşüm, yazılım geliştirme süreçlerini olduğu kadar verinin nasıl saklandığını ve yönetildiğini de yeniden şekillendiriyor. Çünkü modern bir uygulama ne kadar hızlı geliştirilirse geliştirilsin, arkasındaki veritabanı büyüyen iş yükünü taşıyamıyor, arızalara karşı direnç gösteremiyor veya sürekli manuel müdahale gerektiriyorsa sistemin tamamı bundan etkileniyor.
Geleneksel veritabanları uzun yıllardır güvenilir ve güçlü çözümler sunuyor. Ancak çoğu, kaynakların önceden belirlendiği, kapasitenin büyük ölçüde sabit kaldığı ve altyapı değişikliklerinin insan müdahalesiyle gerçekleştirildiği çalışma modelleri etrafında şekillendi. Bulut ortamlarının dinamik yapısı ise çok daha farklı bir yaklaşım gerektiriyor: Kaynakların ihtiyaca göre artırılıp azaltılabilmesi, arızaların otomatik biçimde karşılanması ve hizmetin altyapıdaki değişikliklere rağmen devam edebilmesi.
Bulut-native veritabanı yaklaşımı tam olarak bu ihtiyaca cevap veriyor.
Bulutun yalnızca barındırma kapasitesinden değil, dağıtık ve programlanabilir yapısından da yararlanan bu veritabanları; değişken trafik, büyüyen veri hacmi ve sürekli çalışan uygulamalar için daha esnek bir temel oluşturuyor. Ölçeklendirme, yedeklilik, hata toleransı ve otomasyon gibi yetenekler sonradan eklenen yardımcı özellikler olmaktan çıkarak veritabanı mimarisinin doğal bir parçası hâline geliyor.
Bu nedenle bulut-native veritabanlarını yalnızca “verilerin bulutta tutulduğu sistemler” olarak değerlendirmek eksik kalır. Asıl fark, veritabanının değişen koşullara nasıl tepki verdiğinde ortaya çıkar. Geleneksel bir sistemde kapasite artışı planlama ve manuel yapılandırma gerektirebilirken bulut-native bir veritabanı, desteklediği hizmet modeline bağlı olarak artan iş yüküne otomatik biçimde uyum sağlayabilir. Benzer şekilde, altyapıdaki bir düğümün devre dışı kalması hizmet kesintisine dönüşmeden sistem tarafından karşılanabilir.
Mikroservis mimarileri, küresel ölçekte hizmet veren platformlar, Kubernetes tabanlı sistemler ve trafik yoğunluğu sürekli değişen uygulamalar için bu yetenekler önemli avantajlar sağlar. Bulut-native veritabanları böylece yalnızca teknik bir altyapı tercihi olmaktan çıkar; uygulamanın büyüme kapasitesini, operasyonel dayanıklılığını ve kullanıcı deneyimini doğrudan etkileyen stratejik bir mimari karara dönüşür.
Bulut-Native Veritabanı Nedir?
Bulut-native veritabanı, geleneksel bir veritabanının sanal bir sunucuya kurulup bulut ortamında çalıştırılması değildir. Bir veritabanını buluta taşımak, onu otomatik olarak bulut-native hâle getirmez.
Bulut-native veritabanı; bulut altyapılarının dağıtık, esnek ve sürekli değişebilen çalışma modeline uyum sağlayacak şekilde tasarlanan veritabanı sistemlerini ifade eder. Bu sistemler, kaynakların talebe göre ölçeklendirilmesi, verilerin birden fazla düğüm veya bölge arasında dağıtılması, arızaların otomatik olarak algılanması ve hizmetin mümkün olan en az kesintiyle sürdürülmesi gibi yetenekler üzerine kurulur.
Cloud-native database olarak da adlandırılan bu sistemler; yüksek erişilebilirlik, yatay ölçeklendirme, otomatik kurtarma, hata toleransı ve altyapı otomasyonu gibi özellikleri mimarilerinin doğal bir parçası olarak sunabilir. Böylece uygulamalar kullanıcı sayısındaki artışlara, ani trafik değişikliklerine veya altyapı arızalarına yoğun operasyonel müdahale gerektirmeden uyum sağlayabilir.
Buradaki temel ayrım nettir: Bulutta çalışan bir veritabanı yalnızca çalışma ortamını değiştirmiş olabilir. Bulut-native bir veritabanı ise bulutun sunduğu esneklikten yararlanacak şekilde çalışma, ölçeklenme ve arızalara tepki verme biçimini değiştirmiştir.
Kısacası bulut-native yaklaşım, veritabanının nerede çalıştığından çok değişim karşısında nasıl davrandığıyla ilgilidir.
Bulut-Native ve Geleneksel Veritabanı Arasındaki Farklar
Geleneksel ve bulut-native veritabanları arasındaki fark yalnızca kullanılan sunucu veya veri merkezi değildir. İki yaklaşım; kapasite yönetiminden arıza müdahalesine, dağıtım süreçlerinden maliyet modeline kadar farklı çalışma biçimlerine sahiptir.
| Karşılaştırma alanı | Geleneksel veritabanı | Bulut-native veritabanı |
|---|---|---|
| Mimari | Genellikle merkezi veya sınırlı sayıda sunucuya bağlıdır | Dağıtık düğümler ve servisler üzerine kurulabilir |
| Kapasite planlaması | Kaynaklar çoğunlukla önceden belirlenir | Kaynaklar talebe göre dinamik olarak ayarlanabilir |
| Ölçeklendirme | Çoğunlukla dikey ve manuel ilerler | Dikey veya yatay, bazı hizmetlerde otomatik olabilir |
| Yüksek erişilebilirlik | Ek kurulum ve uzmanlık gerektirebilir | Replikasyon ve failover yetenekleri hizmete yerleşik sunulabilir |
| Bakım ve güncelleme | Büyük ölçüde kurumun sorumluluğundadır | Yönetilen hizmetlerde sağlayıcı tarafından otomatikleştirilebilir |
| Altyapı yönetimi | Konsol ve manuel işlemler ağırlıktadır | API, otomasyon ve IaC araçlarıyla yönetilebilir |
| Coğrafi dağıtım | Kurulumu ve işletimi daha karmaşıktır | Çok bölgeli topolojiler hizmet tarafından desteklenebilir |
| Maliyet modeli | Donanım ve lisans yatırımı ön plandadır | Tüketime veya ayrılmış kapasiteye dayalı olabilir |
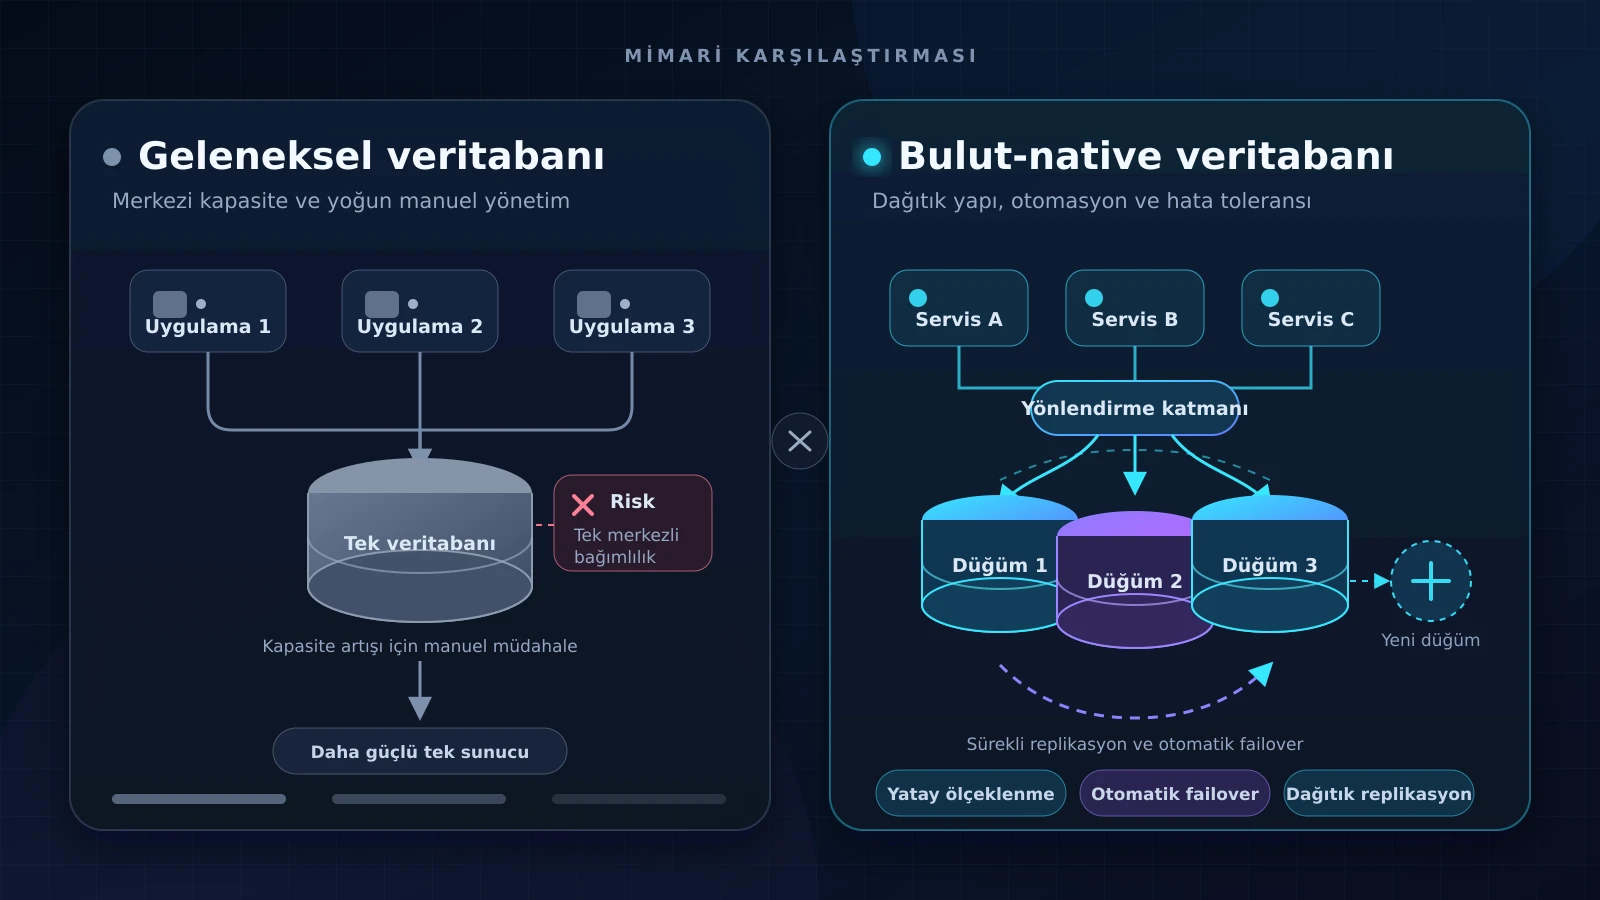
Bu tablo genel eğilimleri gösterir; bütün ürünler aynı davranışı sergilemez. Örneğin geleneksel bir veritabanı doğru araçlarla otomatikleştirilebilirken, bulut-native olarak pazarlanan bir hizmette bazı ölçeklendirme veya felaket kurtarma işlemleri hâlâ kullanıcı yapılandırması gerektirebilir.
Bulut-Native Veritabanlarının Temel Özellikleri
Bulut-native veritabanlarını geleneksel sistemlerden ayıran temel nokta, yalnızca bir bulut sağlayıcısının altyapısında çalışmaları değildir. Asıl fark; ölçeklenme, hata yönetimi, yedeklilik ve operasyonel otomasyon gibi yeteneklerin sistemin çalışma modeline ne ölçüde dahil edildiğiyle ortaya çıkar.
Her bulut tabanlı veritabanı aynı özellikleri sunmaz. Kullanılabilen yetenekler; seçilen veritabanı motoruna, hizmet modeline, dağıtım topolojisine ve sağlayıcının sunduğu servis katmanına göre değişir. Bununla birlikte modern bulut-native veritabanlarında öne çıkan ortak özellikler şunlardır:
Esnek ve Dinamik Ölçeklendirme
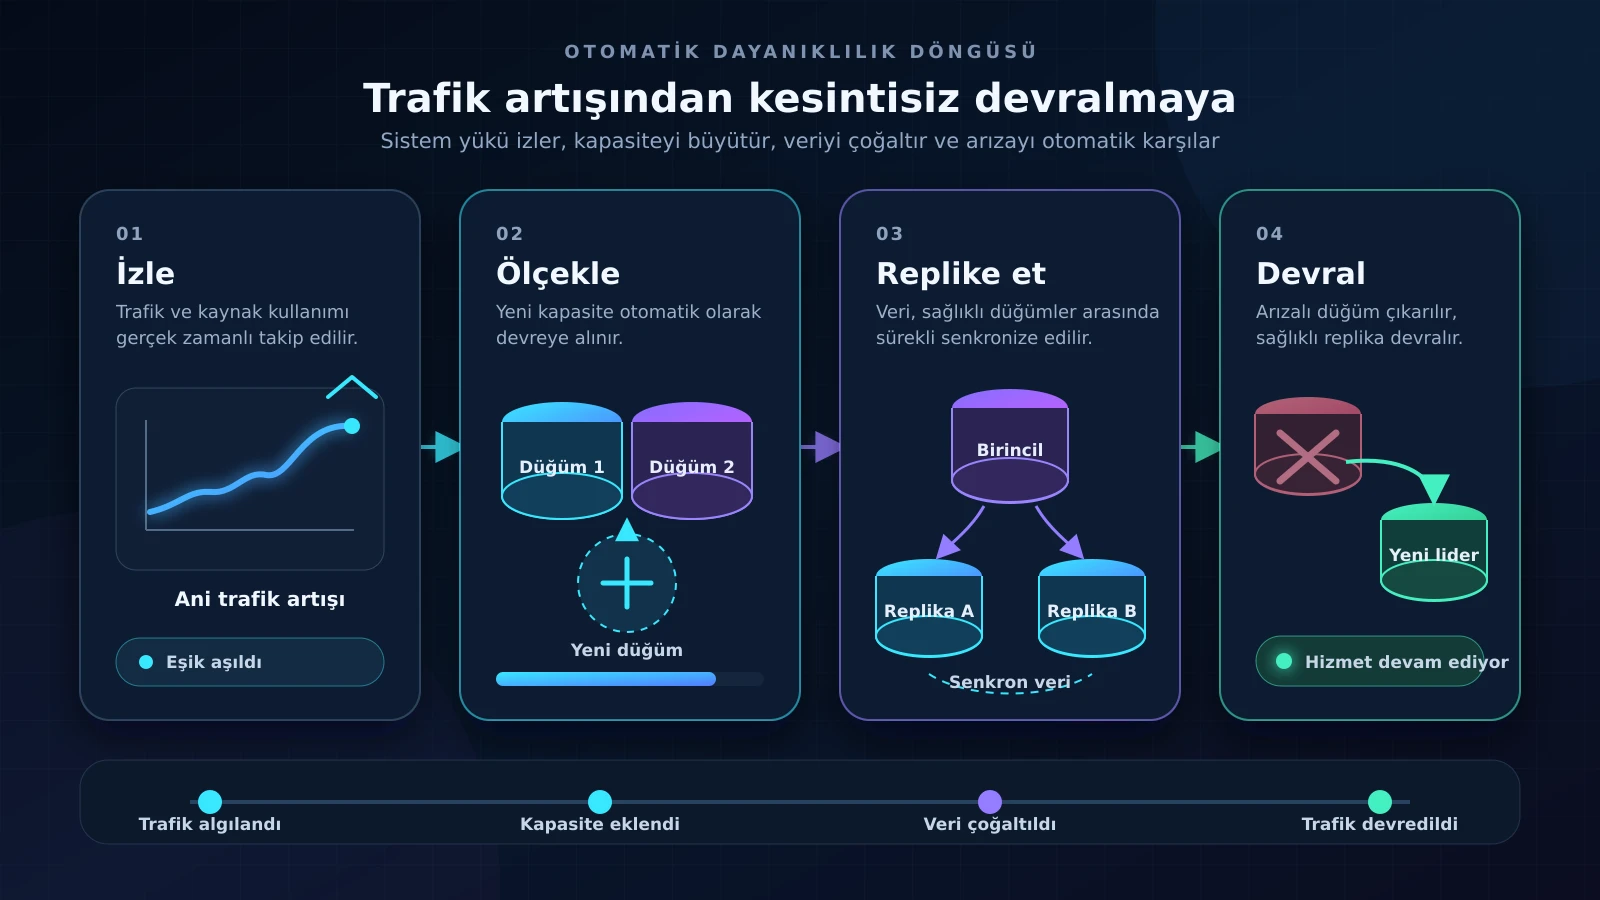
Geleneksel veritabanlarında kapasite artışı çoğu zaman daha güçlü bir sunucuya geçmeyi, bakım penceresi planlamayı veya sistemi manuel olarak yeniden yapılandırmayı gerektirir. Bulut-native mimarilerde ise işlem gücü, bellek, depolama kapasitesi, replika sayısı veya düğüm sayısı iş yüküne göre dinamik biçimde artırılabilir ya da azaltılabilir.
Bu ölçeklendirme iki farklı biçimde gerçekleşebilir:
Dikey ölçeklendirme (vertical scaling): Mevcut veritabanı sunucusuna daha fazla işlemci, bellek veya depolama kaynağı verilmesidir.
Yatay ölçeklendirme (horizontal scaling): İş yükünün birden fazla düğüm, replika veya shard arasında dağıtılmasıdır.
Bazı hizmetler bu işlemleri otomatik olarak gerçekleştirirken bazıları yalnızca kesintisiz veya düşük kesintili kapasite değişikliğine izin verir. Bu nedenle “otomatik ölçeklenebilir veritabanı” değerlendirmesi yapılırken yalnızca ölçeklendirme desteğine değil; hangi kaynağın, hangi sınırlar içinde ve ne kadar otomatik ölçeklendiğine de bakılmalıdır.
Yüksek Erişilebilrlik ve Hata Toleransı
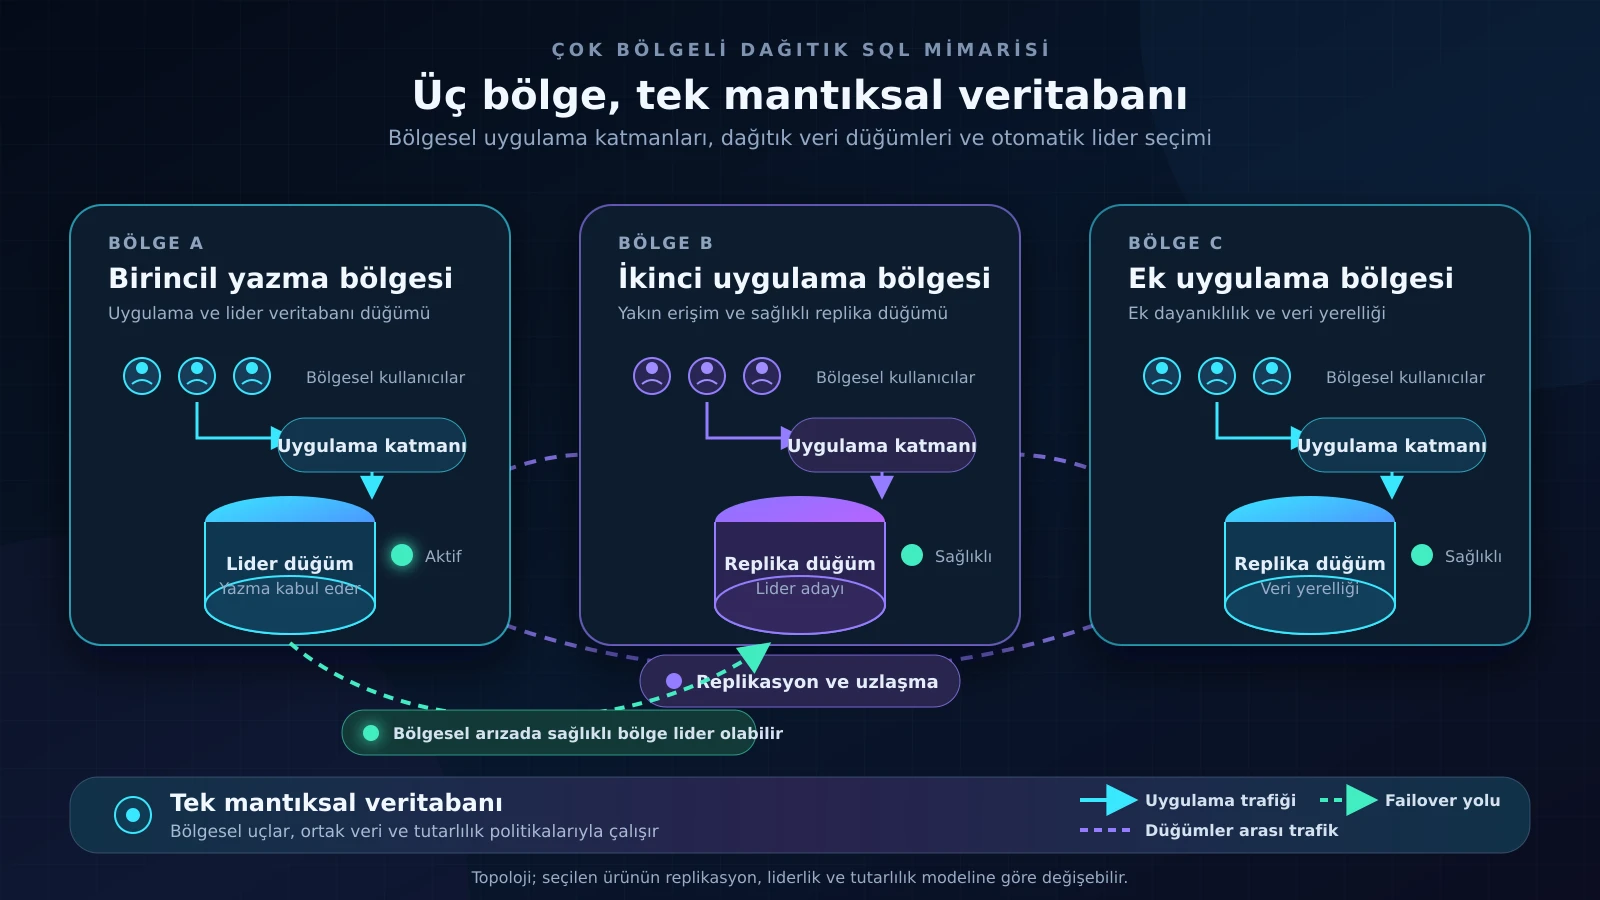
Bulut-native veritabanları, tek bir sunucunun veya erişilebilirlik bölgesinin arızalanmasını sistemin tamamını durduran bir olaya dönüştürmemeyi hedefler. Bu amaçla veriler birden fazla düğümde veya bölgede çoğaltılabilir; sağlık kontrolleri, otomatik lider seçimi ve failover mekanizmalarıyla hizmetin çalışmaya devam etmesi sağlanabilir.
Ancak yüksek erişilebilirlik ile felaket kurtarma aynı kavram değildir. Yüksek erişilebilirlik donanım, ağ veya düğüm arızalarında hizmet sürekliliğini korumaya odaklanırken felaket kurtarma; veri bozulması, yanlışlıkla silme veya bölgesel kesinti gibi olaylardan sonra sistemin geri yüklenmesini kapsar. Sağlam bir bulut veritabanı mimarisinde replikasyon, yedekleme, kurtarma noktası hedefi (RPO) ve kurtarma süresi hedefi (RTO) birlikte planlanmalıdır.
Operasyonel Otomasyon ve Infrastructure as Code
Modern bulut veritabanı hizmetleri; kurulum, yapılandırma, yama yönetimi, yedekleme, izleme ve kapasite değişikliği gibi operasyonların önemli bir bölümünü otomatikleştirebilir. Bu otomasyon, insan hatasını azaltırken aynı veritabanı altyapısının geliştirme, test ve üretim ortamlarında tutarlı biçimde oluşturulmasını kolaylaştırır.
API tabanlı yönetim ve Infrastructure as Code (IaC) araçları sayesinde veritabanı kaynakları kodla tanımlanabilir. Terraform, Pulumi, AWS CloudFormation veya Azure Bicep gibi araçlarla yapılan değişiklikler sürüm kontrolünde tutulabilir, incelenebilir ve CI/CD süreçlerinin parçası hâline getirilebilir. Burada IaC, doğrudan veritabanı motorunun değil, onu yöneten platformun ve otomasyon katmanının sunduğu bir yetenektir.
Serverless Çalışma Modeli
Serverless veritabanı yaklaşımında ekipler fiziksel veya sanal sunucu kapasitesini doğrudan yönetmek yerine hizmetin kullandığı kaynaklara odaklanır. Desteklenen sistemlerde işlem kapasitesi talebe göre otomatik ayarlanabilir; bazı hizmetler uzun süre kullanılmadığında kapasiteyi çok düşük seviyelere, hatta sıfıra kadar indirebilir.
Bu model; geliştirme ve test ortamları, dönemsel kullanılan uygulamalar ve trafiği öngörülemeyen iş yükleri için avantajlı olabilir. Buna karşılık sürekli yüksek yük altında çalışan sistemlerde provisioned kapasite daha öngörülebilir performans ve maliyet sunabilir. Dolayısıyla serverless, bütün bulut-native veritabanlarının zorunlu özelliği veya her iş yükü için varsayılan olarak en iyi seçenek değildir.
Çok Bölgeli Dağıtım ve Veri Yerelliği
Küresel ölçekte çalışan uygulamalarda verinin kullanıcıya yakın bölgelerde tutulması gecikmeyi azaltabilir. Çok bölgeli mimariler aynı zamanda bölgesel arızalara karşı dayanıklılığı artırabilir ve veri yerleşimiyle ilgili yasal gereksinimlerin karşılanmasına yardımcı olabilir.
Bununla birlikte küresel dağıtım ücretsiz bir performans artışı sağlamaz. Güçlü tutarlılık gerektiren işlemlerde farklı bölgeler arasındaki koordinasyon yazma gecikmesini artırabilir. Bu nedenle verinin hangi bölgede tutulacağı, hangi düğümlerin yazma kabul edeceği ve tutarlılık seviyesinin ne olacağı uygulamanın ihtiyaçlarına göre belirlenmelidir.
Gözlemlenebilirlik ve Güvenlik Entegrasyonları
Yönetilen bulut veritabanları; merkezi loglama, performans metrikleri, yavaş sorgu analizi, alarm üretimi ve dağıtık izleme sistemleriyle entegrasyon sağlayabilir. Böylece ekipler yalnızca sistemin çalışıp çalışmadığını değil, performans kaybının hangi sorgudan veya hangi kaynak darboğazından kaynaklandığını da daha hızlı belirleyebilir.
Kimlik ve erişim yönetimi, aktarım ve depolama sırasında şifreleme, anahtar yönetimi, denetim kayıtları ve ağ izolasyonu gibi güvenlik özellikleri de modern veritabanı platformlarının önemli parçalarıdır. Ancak yönetilen hizmet kullanmak güvenlik sorumluluğunu tamamen sağlayıcıya devretmez. Yetkilendirme, veri sınıflandırması, ağ politikaları ve yanlış yapılandırmalar hâlâ kurumun sorumluluğundadır.
Yeni Nesil Uygulamalar İçin Neden Önemlidir?
Yeni nesil uygulamalar yalnızca daha fazla kullanıcıya hizmet vermiyor; aynı zamanda daha sık güncelleniyor, daha fazla servisle haberleşiyor ve çok daha değişken trafik altında çalışıyor. Mikroservis mimarileri, Kubernetes, olay güdümlü sistemler, CI/CD süreçleri ve yapay zekâ destekli özellikler, veri katmanından da benzer bir esneklik bekliyor.
Bulut-native veritabanlarının önemi tam olarak burada ortaya çıkıyor: Uygulama katmanında elde edilen hızın veri katmanında kaybedilmesini önlemeye yardımcı oluyor.
Değişken Trafige Daha Hızlı Karşılık Verir
Kampanyalar, canlı etkinlikler, ürün lansmanları veya beklenmedik kullanıcı ilgisi kısa süre içinde ciddi trafik artışları oluşturabilir. Sabit kapasiteye göre yapılandırılmış bir veritabanı bu artış karşısında darboğaza girebilir. Dinamik ölçeklenme desteği sunan bir bulut tabanlı veritabanı ise kaynakları talebe göre ayarlayarak uygulamanın yanıt süresini ve hizmet sürekliliğini korumaya yardımcı olur.
Yazılım Dağıtım Hızını Destekler
CI/CD ve DevOps süreçlerinin amacı yalnızca uygulama kodunu hızlı yayımlamak değildir. Veritabanı şeması, bağlantı yapılandırmaları, erişim politikaları ve altyapı kaynaklarının da kontrollü biçimde değiştirilebilmesi gerekir. API ve IaC desteği, bu değişikliklerin manuel işlemler yerine tekrarlanabilir otomasyonlarla uygulanmasını sağlar.
Bu yaklaşım ekiplerin geliştirme, test ve üretim ortamları arasındaki yapılandırma farklarını azaltmasına yardımcı olur. Böylece hızlı dağıtım yapılırken kontrol ve izlenebilirlik tamamen kaybedilmez.
Mikroservislerin Bağımsız Büyümesini Kolaylaştırır
Mikroservis mimarisinde her servisin veri erişim modeli ve ölçeklenme ihtiyacı aynı değildir. Sipariş servisi güçlü işlem tutarlılığına ihtiyaç duyarken katalog servisi esnek bir belge modelinden, arama servisi ise metin ve vektör arama yeteneklerinden yararlanabilir.
Bulut-native yaklaşım, her iş yükü için uygun veri modelinin ve ölçeklendirme stratejisinin seçilmesini kolaylaştırır. Ancak bu durum her mikroservisin mutlaka ayrı bir veritabanına sahip olması gerektiği anlamına gelmez. Fazla sayıda bağımsız veritabanı; veri tutarlılığı, gözlemlenebilirlik, güvenlik ve maliyet yönetimini zorlaştırabilir. Mimari karar, servis sınırları ve operasyonel kapasite birlikte değerlendirilerek verilmelidir.
Kubernetes ile Uyumlu Bir Operasyon Modeli Sunar
Kubernetes tabanlı uygulamalar dinamik olarak ölçeklenebilir ve arızalanan bileşenleri yeniden oluşturabilir. Veritabanı katmanının da bu çalışma modeline uyum sağlaması önemlidir. Kubernetes Operator çözümleri, durum bilgisi taşıyan veritabanlarının kurulumu, güncellenmesi ve yedeklenmesi için otomasyon sağlayabilir.
Bununla birlikte uygulamanın Kubernetes üzerinde çalışması, veritabanının da aynı kümenin içinde çalıştırılması gerektiği anlamına gelmez. Birçok üretim ortamında uygulama Kubernetes üzerinde çalışırken veri katmanı küme dışında konumlandırılmış yönetilen bir veritabanı hizmeti olarak kullanılır. Bu model, veritabanı operasyonlarının bir bölümünü sağlayıcıya devrederek uygulama ekiplerinin üzerindeki yükü azaltabilir.
Yapay Zekâ ve Modern Arama İş Yüklerini Destekleyebilir
Güncel veritabanı platformları artık yalnızca tablo veya belge saklamakla sınırlı değil. Bazı modern hizmetler JSON, grafik, zaman serisi, tam metin arama ve vektör veri türlerini aynı veri platformunda destekleyebiliyor. Vektör arama yetenekleri; anlamsal arama, öneri sistemleri ve retrieval-augmented generation (RAG) tabanlı yapay zekâ uygulamalarında kullanılabiliyor.
Bu yakınsamadır, ayrı veri sistemleri arasında sürekli senkronizasyon ihtiyacını azaltabilir. Ancak operasyonel veritabanına yapay zekâ iş yükü eklenirken sorgu izolasyonu, indeks maliyeti, gecikme ve kapasite planlaması ayrıca değerlendirilmelidir.
Peki her Bulut Tabanlı Veritabanı Bulut-Native mıdır?
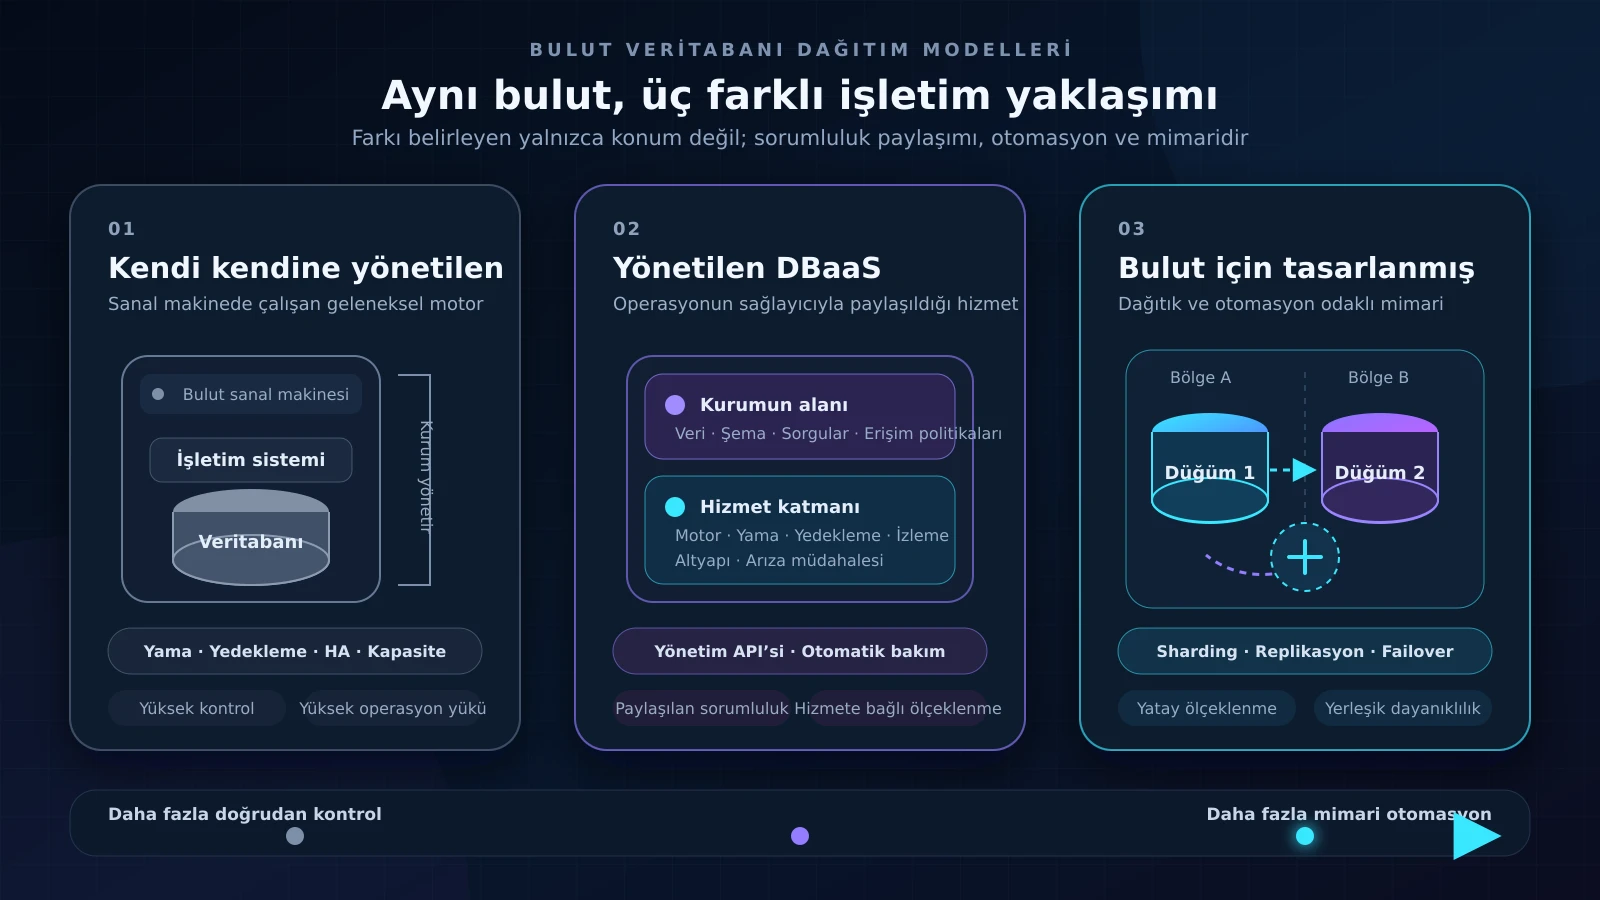
Hayır. Bir veritabanının AWS, Microsoft Azure, Google Cloud veya başka bir bulut altyapısında çalışması onu tek başına bulut-native yapmaz. Bulut veritabanı çözümleri genel olarak üç farklı modelde değerlendirilebilir:
Bulutta Çalışan Kendi Kendine Yönetilen Veritabanı
Bu modelde geleneksel bir veritabanı sanal makineye kurulur ve kurum tarafından yönetilir. Sunucu, depolama ve ağ bulut sağlayıcısından alınsa da yama, yedekleme, güvenlik, yüksek erişilebilirlik ve kapasite planlaması büyük ölçüde kurumun sorumluluğunda kalır.
Lift-and-shift olarak adlandırılan bu yaklaşım hızlı geçiş sağlayabilir fakat bulutun otomasyon ve esneklik avantajlarından sınırlı ölçüde yararlanır.
Yönetilen Veritabanı Hizmeti (DBaaS)
Database as a Service modelinde kurulum, yedekleme, yama yönetimi, izleme ve arıza müdahalesi gibi görevlerin önemli bölümü sağlayıcı tarafından yürütülür. Amazon RDS for SQL Server, Azure SQL Managed Instance ve SAP Adaptive Server Enterprise, cloud edition by IBM Cloud gibi hizmetler bu modele örnek verilebilir.
DBaaS kullanmak operasyonel yükü azaltır; ancak temel veritabanı motorunun otomatik olarak dağıtık veya gerçek anlamda cloud-native bir mimariye dönüştüğü anlamına gelmez.
Bulut İçin Tasarlanmış Dağıtık Veritabanı
Bu gruptaki sistemlerde dağıtık depolama, otomatik sharding, yatay ölçeklenme, çok bölgeli replikasyon ve arıza toleransı mimarinin temel parçalarıdır. Google Cloud Spanner, CockroachDB, YugabyteDB ve Amazon Aurora gibi çözümler farklı mimari yaklaşımlarla bu kategoride değerlendirilebilir.
Bu üç model arasında kesin ve herkes tarafından kabul edilen bir sınır yoktur. Bir hizmet bazı alanlarda cloud-native davranırken başka alanlarda manuel kapasite yönetimi veya geleneksel veritabanı kısıtları barındırabilir. Bu nedenle ürün seçerken pazarlama tanımlarından çok gerçek mimari yeteneklere bakılmalıdır.
Farklı Veritabanları Bulut Ortamlarına Nasıl Uyum Sağlıyor?
Günümüzde geleneksel ilişkisel veritabanlarından dağıtık NoSQL sistemlerine kadar pek çok ürün, yönetilen hizmetler veya bulut için yeniden tasarlanmış sürümler aracılığıyla modern altyapılara uyum sağlıyor. Ancak her ürünün buluta yaklaşımı aynı değil.
Microsoft SQL Server ve Azure SQL
Microsoft SQL Server, uzun yıllardır kurumsal uygulamalarda kullanılan geleneksel bir ilişkisel veritabanı motorudur. SQL Server iş yükleri bulutta sanal makineler üzerinde çalıştırılabileceği gibi Azure SQL Database, Azure SQL Managed Instance ve Amazon RDS for SQL Server üzerinden yönetilen hizmet olarak da kullanılabilir.
Burada SQL Server motoru ile Azure SQL hizmetlerini birbirinden ayırmak önemlidir. Azure SQL Database; otomatik yedekleme, yama yönetimi ve yüksek erişilebilirlik gibi operasyonları yönetilen servis katmanında sunar. Otomatik işlem gücü ölçeklendirmesi ise bütün katmanlarda aynı değildir; serverless seçeneğinde kapasite belirlenen aralık içinde iş yüküne göre otomatik ayarlanabilir.
Microsoft ekosistemindeki güncel gelişmelerden biri de SQL Server 2025 ve ilgili Azure SQL hizmetlerinde sunulan yerleşik vektör veri türü ve vektör arama yetenekleridir. Bu özellikler, ilişkisel verilerle yapay zekâ tabanlı benzerlik aramalarının aynı veri platformunda birleştirilmesini mümkün kılar.
MariaDB Cloud
MariaDB, açık kaynaklı ilişkisel yapısı ve MySQL ekosistemiyle uyumluluğu sayesinde web uygulamalarından kurumsal sistemlere kadar geniş bir kullanım alanına sahiptir. Güncel bulut hizmeti MariaDB Cloud; provisioned ve serverless dağıtım seçenekleri sunarak farklı iş yüklerinin aynı platform üzerinden yönetilmesini sağlar.
Serverless model, boşta kaldığında kapasiteyi sıfıra kadar indirebilen ve trafik geri döndüğünde yeniden devreye girebilen bir yapı sunar. Sürekli çalışan kritik sistemlerde ise önceden ayrılmış kapasite daha öngörülebilir bir tercih olabilir. Bu iki modelin aynı hizmet altında sunulması, maliyet ve performans gereksinimlerine göre seçim yapılmasını kolaylaştırır.
MongoDB Atlas
MongoDB, belge tabanlı veri modeli sayesinde şeması sık değişen veya iç içe veri yapıları kullanan uygulamalarda esneklik sağlar. Yönetilen bulut platformu MongoDB Atlas; otomatik ölçeklendirme, yedekleme, çok bölgeli dağıtım ve otomatik failover gibi yetenekleri merkezi olarak sunar.
Atlas ayrıca operasyonel veriler üzerinde metn, hibrit ve vektör arama yapılmasını sağlayan MongoDB Vector Search özelliğini destekler. Bu yapı, belge verisi ile vektör embedding'lerinin aynı platformda tutulmasını sağlayarak anlamsal arama ve RAG tabanlı uygulamalarda ayrı bir senkronizasyon katmanına duyulan ihtiyacı azaltabilir.
Oracle Autonomous AI Database
Oracle Database, yüksek işlem hacmine sahip kurumsal sistemlerde uzun süredir kullanılan güçlü bir ilişkisel veritabanıdır. Oracle Autonomous AI Database; yama yönetimi, bakım, güvenlik ve kapasite işlemlerinin önemli bir bölümünü otomatikleştirerek geleneksel Oracle iş yüklerini yönetilen bir bulut modeline taşır.
Hizmette işlem gücü için otomatik ölçeklendirme varsayılan olarak etkinleştirilebilirken depolama ölçeklendirmesi ayrı olarak yapılandırılabilir. SQL, JSON, grafik, coğrafi veri ve vektör gibi farklı veri modellerinin aynı platformda desteklenmesi, modern analitik ve yapay zekâ uygulamaları açısından önemli bir esneklik sağlar.
SAP Adaptive Server Enterprise (SAP ASE)
Geçmişte Sybase ASE adıyla bilinen SAP Adaptive Server Enterprise, özellikle finans, bankacılık ve SAP tabanlı kurumsal sistemlerde kullanılan ilişkisel bir veritabanıdır. SAP ASE'nin temel motoru doğrudan bulut-native olarak tasarlanmamıştır; ancak public cloud üzerinde IaaS modeliyle veya SAP Adaptive Server Enterprise, cloud edition by IBM Cloud üzerinden yönetilen hizmet olarak çalıştırılabilir.
Bu yaklaşımın temel amacı, mevcut ve kritik iş yüklerini tamamen yeniden yazmadan buluta taşımaktır. Yönetilen sürüm; yüksek erişilebilirlik, yedekleme, güvenlik ve bakım süreçlerini hizmet katmanına aktarabilir. Dolayısıyla SAP ASE, bulut-native veritabanından çok geleneksel bir veritabanının yönetilen bulut hizmetine dönüştürülmesine iyi bir örnektir.
Bulut İçin Tasarlanmış Dağıtık SQL Çözümleri
Google Cloud Spanner, CockroachDB ve YugabyteDB gibi dağıtık SQL (distributed SQL) sistemleri, ilişkisel veritabanlarının SQL ve işlem tutarlılığı özelliklerini dağıtık mimarinin yatay ölçeklenme ve hata toleransı yetenekleriyle birleştirmeyi amaçlar.
Google Cloud Spanner otomatik sharding, yatay okuma ve yazma ölçeklenmesi ile bölgesel ve çok bölgeli dağıtım seçenekleri sunar. CockroachDB, veri yerelliği ve bölgesel hayatta kalma hedeflerinin tanımlanabildiği çok bölgeli topolojilere odaklanır. YugabyteDB ise verileri düğümler arasında shard ve replika hâlinde dağıtan, PostgreSQL uyumlu bir distributed SQL yaklaşımı sunar.
Amazon Aurora da MySQL ve PostgreSQL uyumluluğunu dağıtık ve paylaşımlı bir depolama mimarisiyle birleştirir. Aurora Serverless v2 seceneği, işlem kapasitesinin uygulama talebine göre otomatik olarak ayarlanmasını sağlar.
Bu ürünler aynı problemi aynı yöntemle çözmez. Tutarlılık modeli, SQL uyumluluğu, gecikme, taşınabilirlik, sağlayıcı bağımlılığı ve operasyonel karmaşıklık bakımından aralarında ciddi farklar bulunur.
Bulut Geçişi İşletim Modelini Nasıl Değiştirir?
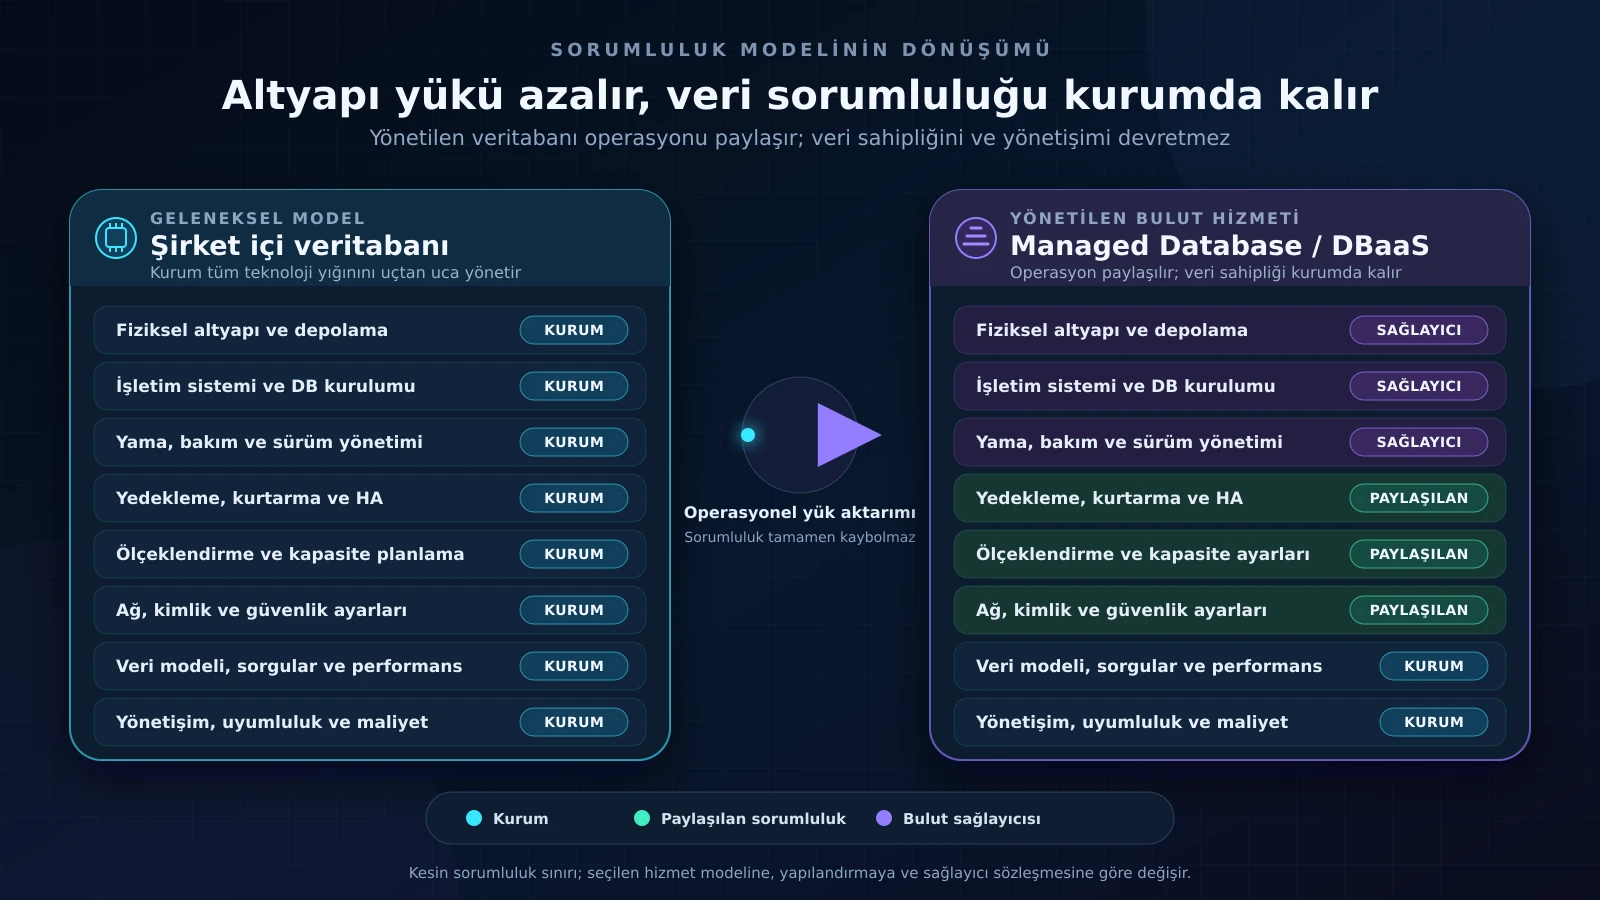
Veritabanını buluta taşımak yalnızca sunucunun konumunu değiştirmek değildir. Doğru uygulandığında altyapının nasıl sağlandığını, güvenliğin nasıl yönetildiğini, arızalara nasıl müdahale edildiğini ve ekiplerin hangi sorumlulukları üstlendiğini de değiştirir.
Geleneksel modelde kurum; donanım tedariği, işletim sistemi, veritabanı kurulumu, yama yönetimi, yedekleme, kapasite planlaması ve yüksek erişilebilirlik mimarisinden sorumludur. Yönetilen veritabanı hizmetinde bu görevlerin bir bölümü sağlayıcı tarafından üstlenilir. Buna karşılık veri modeli, sorgu performansı, erişim politikaları, maliyet kontrolü, veri yönetişimi ve uygulama mimarisi kurumun sorumluluğunda kalmaya devam eder.
Bu değişim, veritabanı yöneticilerine duyulan ihtiyacı ortadan kaldırmaz; rollerini dönüştürür. Fiziksel sunucu ve rutin bakım işleri azalırken performans mühendisliği, veri güvenliği, maliyet optimizasyonu, otomasyon, yönetişim ve felaket kurtarma testleri daha önemli hâle gelir.
Maliyet Modeli de Değişir
Bulut tabanlı veritabanı hizmetleri genellikle kullandıkça öde veya ayrılmış kapasite modelleriyle sunulur. Bu yapı yüksek başlangıç yatırımlarını azaltabilir ve maliyeti gerçek kaynak tüketimiyle ilişkilendirebilir. Fakat buluta geçiş otomatik olarak daha düşük maliyet anlamına gelmez.
Sürekli açık tutulan büyük veritabanları, gereksiz replikalar, yüksek IOPS kullanımı, çok bölgeli veri transferi ve kontrolsüz yedekleme politikaları beklenenden yüksek faturalar oluşturabilir. Bu nedenle FinOps yaklaşımı, kaynak etiketleme, bütçe alarmları ve düzenli kapasite analizi veritabanı işletiminin parçası olmalıdır.
Sağlayıcı Bağımlılığı ve Taşınabilirlik Değerlendirilmelidir
Yönetilen hizmetler operasyonel kolaylık sağlarken sağlayıcıya özgü API'ler, veri türleri ve entegrasyonlar taşınabilirliği azaltabilir. Standart SQL veya yaygın açık kaynak uyumluluğu geçişi kolaylaştırabilir; ancak tam uyumluluk iddiaları mutlaka uygulamanın gerçek sorguları ve araçlarıyla test edilmelidir.
Veritabanı seçimi yapılırken yalnızca bugünkü performans değil, verinin başka bir bölgeye veya sağlayıcıya nasıl taşınacağı, dışa aktarma seçenekleri ve çıkış maliyeti de değerlendirilmelidir.
Modern Uygulamalar İçin Doğru Veritabanını Seçmek
Bulut-native veritabanları modern uygulamalara güçlü bir ölçeklenme, dayanıklılık ve otomasyon temeli sunar. Ancak hiçbir veritabanı yalnızca “cloud-native” etiketi taşıdığı için her proje için doğru seçenek hâline gelmez.
Doğru karar; veri modeli, işlem tutarlılığı, sorgu biçimleri, trafik yapısı, gecikme hedefleri, yasal gereksinimler, ekip deneyimi ve toplam sahip olma maliyeti birlikte değerlendirilerek verilir. Küresel ölçekte çalışan bir ödeme sistemiyle dönemsel kullanılan bir yönetim panelinin ihtiyaçları aynı değildir. Benzer şekilde yoğun yazma alan bir işlem sistemiyle vektör arama yapan bir yapay zekâ uygulaması aynı veritabanı mimarisini gerektirmeyebilir.
Bu nedenle seçim sürecinde yalnızca “hangi veritabanı daha hızlı?” sorusu sorulmamalıdır. Şu sorular da yanıtlanmalıdır:
- Sistem yatay olarak ölçeklenebiliyor mu, yoksa yalnızca daha güçlü sunuculara mı bağımlı?
- Yüksek erişilebilirlik hangi arıza senaryolarını kapsıyor?
- Yedekleme ve felaket kurtarma süreçleri gerçekten test edildi mi?
- Çok bölgeli dağıtımın tutarlılık ve gecikme üzerindeki etkisi nedir?
- Serverless ve kullandıkça öde modeli bu iş yükünde gerçekten avantajlı mı?
- Güvenlik, gözlemlenebilirlik ve IaC entegrasyonları yeterli mi?
- Veriler gerektiğinde başka bir platforma taşınabilir mi?
Modern uygulamalar modern veri altyapıları gerektirir; fakat modernlik yalnızca yeni bir ürün kullanmak değildir. Asıl modern yaklaşım, veritabanını uygulamanın büyüme biçimine, operasyonel gerçeklerine ve uzun vadeli hedeflerine uygun olarak tasarlamaktır.